Blog · Pumpkin Labs

Insights sobre IA e tecnologia

Explorando Graph RAG, Answer Engine Optimization, agentes inteligentes e o futuro da IA empresarial.

Pumpkin LabsPumpkin ExplicaFundamentosEnsaio Nº 20
A matemática por
trás da similaridade
semântica
Pumpkin Labs
Similaridade semântica
Por Pumpkin Labs · Pesquisa
pumpkinlabs.io
~13 min · jul 2026
Vetores e ângulo · esquemático
Fig. 01
01.
Vetores
ângulo θ
02.
cos θ
de −1 a 1
03.
Onde falha
restrições
mesma direção → cos θ ≈ 1 · quando o cosseno engana
S01 · E20
Inteligência Artificial
Similaridade semântica: como o cosseno funciona e onde falha
20 Jul 202613 min

Entenda por que a similaridade semântica (cosseno) falha em perguntas de e-commerce como 'geladeira frost free até R$ 3.000' e como contornar essa limitação combinando busca semântica com filtros determinísticos.

Ler artigo completo
Pumpkin LabsPumpkin ExplicaMercadoEnsaio Nº 19
B2A: vendendo
para agentes
de IA
Pumpkin Labs
A era B2A
Por Pumpkin Labs · Pesquisa
pumpkinlabs.io
~13 min · jul 2026
Máquina para máquina · esquemático
Fig. 03
01.
Agente
comprador
02.
B2A
máquina↔máquina
03.
Mercado
sem humanos
seu cliente → um agente · não uma pessoa
S01 · E19
SEO & AEO
A era B2A: por que sua empresa vai vender para agentes de IA, não para pessoas
20 Jul 202613 min

A venda para agentes de IA (B2A) está transformando o comércio. Quando quem pesquisa, compara e decide a compra é um agente, a unidade de distribuição deixa de ser o clique e passa a ser a citação, e a unidade de confiança deixa de ser a marca e passa a ser o fato verificável. Entenda o que isso muda no seu site, nos seus dados e nas suas APIs.

Ler artigo completo
Pumpkin LabsPumpkin ExplicaAgentesEnsaio Nº 18
O que é
engenharia
de contexto
Pumpkin Labs
Engenharia de contexto
Por Pumpkin Labs · Pesquisa
pumpkinlabs.io
~13 min · jul 2026
Janela de contexto · esquemático
Fig. 02
01.
Janela
tokens
02.
Orçamento
alocação
03.
Limite
descarte
recurso escasso → a janela · o orçamento
S01 · E18
Inteligência Artificial
O que é engenharia de contexto: o recurso mais escasso do seu agente
20 Jul 202613 min

Engenharia de contexto é a disciplina de decidir o que entra, o que fica de fora e em que ordem na janela do LLM. Este post mostra por que recuperar os trechos mais similares não é montar o melhor contexto e por que engenharia de contexto é responsabilidade do harness, não do modelo.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsEnsaio nº 17Produção
Onde o dinheiro some entre uma resposta e outra
Custo de
agentes de IA
em produção
Pumpkin Labs
Custo de agentes de IA em produção
Por Vivian Kang · Co-fundadora
pumpkinlabs.io
~13 min · jul 2026
Três eixos de custo · esquemático
Fig. 17
sys
hist
tools
out
tokens por chamada
01.
Contexto
o que entra
req
n1
n2
n3
n4
1 pergunta → n chamadas
02.
Loop
passos ocultos
$↑
·
·
·
×
·
·
latência →
fronteira de custo
03.
Trade-off
rápido = caro
O fio condutor → custo por tarefa, não por token
S01 · E17
Inteligência Artificial
Custo de agentes de IA em produção: compute fixo, não preço por token
07 Jul 202613 min

O custo de agentes de IA em produção só é previsível quando você não paga por token. Rodando modelos pequenos em compute fixo, a variância que quebra orçamentos deixa de virar conta: o pico custa latência, não dinheiro.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsEnsaio nº 16Engenharia
Trocar de modelo não conserta o sistema em volta dele
Confiabilidade
de agentes não é
problema de
modelo
Pumpkin Labs
Confiabilidade de agentes de IA
Por Vivian Kang · Co-fundadora
pumpkinlabs.io
~13 min · jul 2026
Onde a confiança quebra · esquemático
Fig. 16
plan · 0,95
call · 0,95
parse · 0,95
act · 0,95
0,95⁴ ≈ 0,81
01.
A corrente
erros compõem
saída
validar
aceitar
retry
validar → repetir
02.
O arnês
onde se conserta
tool i/o41%
formato27%
contexto21%
modelo11%
de onde vêm as falhas
03.
As fontes
modelo é minoria
O fio condutor → confiabilidade é arquitetura
S01 · E16
Inteligência Artificial
Confiabilidade de agentes de IA não é problema de modelo
07 Jul 202613 min

Confiabilidade de agentes de IA não é um problema de inteligência do modelo, mas de controle sobre o espaço de ações. Este post mostra como restrições duras, rollback e observação fresca substituem prompts vagos para criar agentes confiáveis.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsEnsaio nº 15Avaliação
O placar sobe, o agente cai — e ninguém percebe
Benchmarks de
LLM em
produção
Por que seu agente falha onde o benchmark não vê.
Pumpkin Labs
Benchmarks de LLM em produção
Por Vivian Kang · Co-fundadora
pumpkinlabs.io
~13 min · jul 2026
O que o placar não mede · esquemático
Fig. 15
bench
prod
Δ = 45 pts
acerto declarado × real
01.
O placar
não é a tarefa
Q
benchmark
t1
t2
t3
produção
1 turno × muitos passos
02.
O contexto
loop, não turno
bench
·
·
·
·
real
?
?
fora da distribuição
03.
Os dados
o mundo é sujo
O fio condutor → avalie a tarefa, não o placar
S01 · E15
Inteligência Artificial
Benchmarks de LLM em produção: por que seu agente falha onde o benchmark não vê
07 Jul 202613 min

Entenda por que os benchmarks de LLM em produção não preveem o desempenho real e como construir agentes confiáveis. A lacuna entre benchmark e produção é estrutural: variabilidade, falhas de ferramenta e instabilidade do modelo derrubam até os melhores agentes. Saiba como monitorar e projetar sistemas que sobrevivem ao mundo real.

Ler artigo completo
Pumpkin LabsPumpkin ExplicaSérieEnsaio Nº 14
Guia prático de AEO
Como deixar seu site
legível para LLMs
Pumpkin Labs
pumpkin explica · pt-br
pumpkinlabs.io
~12 min · junho 2026
camadas de legibilidade · esquemático
Fig. 01–03
01.
Schema
json-ld article
02.
Headers
perguntas em h2
03.
Recorte
bloco autocontido
schema nas páginas citadas → ≈81% · guia de aeo
S01 · E14
SEO & AEO
Como deixar seu site legível para LLMs: guia prático de AEO
30 Jun 202612 min

Aprenda como deixar seu site legível para LLMs com schema Article e FAQPage, headers em formato de pergunta, respostas autocontidas e o arquivo llms.txt. Um guia prático de AEO para ser citado por IAs como o ChatGPT.

Ler artigo completo
Pumpkin LabsPumpkin ExplicaSérieEnsaio Nº 13
Fatos soltos não
formam significado
O grafo entrega os fatos certos, mas é a ontologia que diz quais combinações são válidas, e sem ela toda pergunta composta vira um palpite.
Pumpkin Labs
Ontologia e grafo de conhecimento
Por Vivian Kang · Co-fundadora
pumpkinlabs.io
~13 min · jun 2026
As camadas do significado · esquemático
Fig. 13
01.
Grafo
fatos atômicos
02.
Ontologia
a gramática
03.
Verbalizar
só o verificado
Inteligência Artificial
Ontologia e grafo de conhecimento: a arquitetura que faz a IA parar de chutar
30 Jun 202613 min

Entenda por que o grafo de conhecimento sozinho não garante respostas corretas e como a ontologia, a orquestração semântica e a verbalização controlada formam as camadas necessárias para um agente de IA confiável.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 12
Fine-tuning
vs harness
Pumpkin Labs
Engenharia de Modelos
Por Pumpkin Labs · Pesquisa
pumpkinlabs.io
~9 min · 2026
Duas formas de adaptar · esquemático
Fig. 12
01.
Fine-tuning
altera os pesos
02.
Harness
orquestra o modelo
03.
Custo
esforço · iteração
tempo até a 1ª iteração → −84% · a favor do harness
S01 · E12
Inteligência Artificial
Fine-tuning vs harness: quando o retreino vale a pena (e quando não)
30 Jun 20269 min

A maioria do que parece exigir fine-tuning (regras de negócio, consulta a dados, formato de saída) cabe no harness: contexto via RAG, guardrails e orquestração. Quatro perguntas para decidir antes de retreinar, por que o prompt age como um LoRA em tempo de execução, e onde o fine-tuning é, de fato, a ferramenta certa.

Ler artigo completo
Pumpkin LabsPumpkin ExplicaSérieEnsaio Nº 11
O que é um
agente de IA
Pumpkin Labs
Pumpkin Explica · #11
pumpkinlabs.io
ensaio nº 11 · 2026
O espectro de autonomia · esquemático
Fig. 11
01.
Workflow
caminho fixo
02.
Automação
decisão controlada
03.
Agente
loop de decisão
chamar workflow de agente → 3× custo · o erro mais caro
S01 · E11
Inteligência Artificial
O que é um agente de IA: a linha entre workflow, automação e decisão real
23 Jun 20269 min

O que é um agente de IA? Aprenda a diferença entre workflow, automação e um agente de verdade, com um teste de três perguntas para classificar qualquer sistema. Entenda por que chamar um workflow de agente é o erro mais comum e mais caro.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 10
O que é
esquecimento
catastrófico?
Treinar um modelo numa nova tarefa pode apagar o que ele já dominava, sem aviso, de uma só vez.
Pumpkin Labs
Aprendizado contínuo
Por Pumpkin Labs · Pesquisa
pumpkinlabs.io
~8 min · jun 2026
Espaço de pesos · esquemático
Fig. 10
01.
Vales
perda × pesos
02.
Gradiente
→ vale b
03.
Trajetória
a → b
perda da tarefa A após treinar B → sobe · o custo do esquecimento
S01 · E10
Inteligência Artificial
Esquecimento catastrófico: quando o modelo simplesmente esquece
23 Jun 202612 min

Esquecimento catastrófico: entenda por que o fine-tuning sequencial apaga o conhecimento anterior em LLMs e como o harness da Pumpkin elimina o problema sem retreinar o modelo.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsConceitoEnsaio Nº 09
O que é
Destilação
Online?
Pumpkin Labs
Pumpkin Explains
Aprendizado de Máquina
pumpkinlabs.io
~7 min · jun 2026
Destilação de conhecimento · esquemático
Fig. 09
01.
Professor → Aluno
transferência
02.
Soft targets
temperatura
03.
Online
simultâneo
modelo grande → modelo pequeno · mesma capacidade
S01 · E09
Inteligência Artificial
Destilação online: o mecanismo que transfere competência entre modelos sem retreino
22 Jun 20267 min

Quando a camada de prompt do harness é escrita por um modelo grande, ela vira um veículo de destilação online: a competência do professor migra para o aluno via contexto, não via pesos. O mecanismo por trás disso, a comparação com a destilação clássica, e por que ela compõe múltiplos professores sem conflito.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieComo os LLMs aprendem
Como os LLMs
são treinados
Antes de acertar uma palavra, o modelo treina: prevê o próximo token, mede o quanto errou e ajusta os pesos, milhões de vezes.
Pumpkin Labs
Como os LLMs aprendem
Ensaio em cinco esquemas
pumpkinlabs.io
~9 min · leitura
Como o modelo aprende · esquemático
Fig. 01–03
01.
Tokenização
pares de treino
02.
Backprop
erro para trás
03.
Gradiente
descendo a perda
● os três motores → tokenização, backpropagation e gradiente descendente
Inteligência Artificial
Como os LLMs são treinados: tokenização, backpropagation e gradiente descendente
19 Jun 202613 min

Descubra como os LLMs são treinados, do texto cru aos pesos finais: tokenização, cross-entropy, backpropagation e gradiente descendente, passo a passo, com um glossário no fim.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 07
Seu agente não
precisa de um
modelo maior
Um bom prompt já é um LoRA. A matemática de por que modelos pequenos bastam.
Pumpkin Labs
Como funcionam os LLMs
Por Pumpkin Labs · pesquisa
pumpkinlabs.io
~12 min · jun 2026
A intuição em cinco esquemas · esquemático
Fig. 01–05
01.
Produto externo
vira rank 1
02.
Fast weight
o peso age
03.
SVD
amplifica σ
modelo extra necessário → 0 · um bom prompt já é um LoRA
S01 · E07
Inteligência Artificial
Seu agente não precisa de um modelo maior
18 Jun 202612 min

A maior parte dos passos de um agente é execução, não estratégia, e execução não precisa do modelo mais forte. A matemática da atenção mostra por que um bom prompt age como um LoRA em tempo de execução: um delta de baixo rank que um modelo pequeno e obediente sabe receber.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 06
O que é o
LoRA
Pumpkin Labs
Como funcionam os LLMs
Por Vivian Kang · Co-fundadora
pumpkinlabs.io
~11 min · junho 2026
Adaptação de rank baixo · esquemático
Fig. 07
≈
01.
ΔW = B·A
duas matrizes finas
02.
d → r → d
o gargalo
03.
W + BA
fusão sem custo
treina 65 mil, não 16,7 mi → 256× menos
S01 · E06
Inteligência Artificial
O que é LoRA: Low-Rank Adaptation
16 Jun 202611 min

LoRA (Low-Rank Adaptation) é uma técnica que permite ajustar modelos grandes treinando apenas 0,4% dos parâmetros, reduzindo o custo em mais de 99% sem perder qualidade. Entenda como funciona a decomposição de rank baixo.

Ler artigo completo
O que é in-context learning? Como um modelo aprende sem treinar
Inteligência Artificial
O que é in-context learning? Como um modelo aprende sem treinar
15 Jun 202614 min

In-context learning explicado por dentro: como exemplos no prompt fazem o modelo executar uma tarefa nova sem ajustar nenhum peso, por que isso acontece no forward pass, e qual o mecanismo (induction heads) por trás.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 06
Como funciona a
self-attention
Pumpkin Labs
Como funcionam os LLMs
Por Vivian Kang · Co-fundadora
pumpkinlabs.io
~12 min · junho 2026
Anatomia da atenção · esquemático
Fig. 06
01.
Q · K · V
três papéis
02.
Grade n×n
custo ao quadrado
03.
Significado
polos opostos
foco em "banco" → 79% do peso vai pra "dinheiro"
S01 · E06
Inteligência Artificial
Como funciona a self-attention: query, key, value e o cálculo da atenção
11 Jun 202614 min

Self-attention explicada por dentro: como query, key e value, o produto escalar e o softmax fazem cada palavra olhar para todas as outras, e por que isso custa no quadrado do tamanho do contexto.
Ler artigo completo
O que o ChatGPT vê quando escolhe quem citar
SEO & AEO
O que o ChatGPT vê quando escolhe quem citar
08 Jun 202613 min

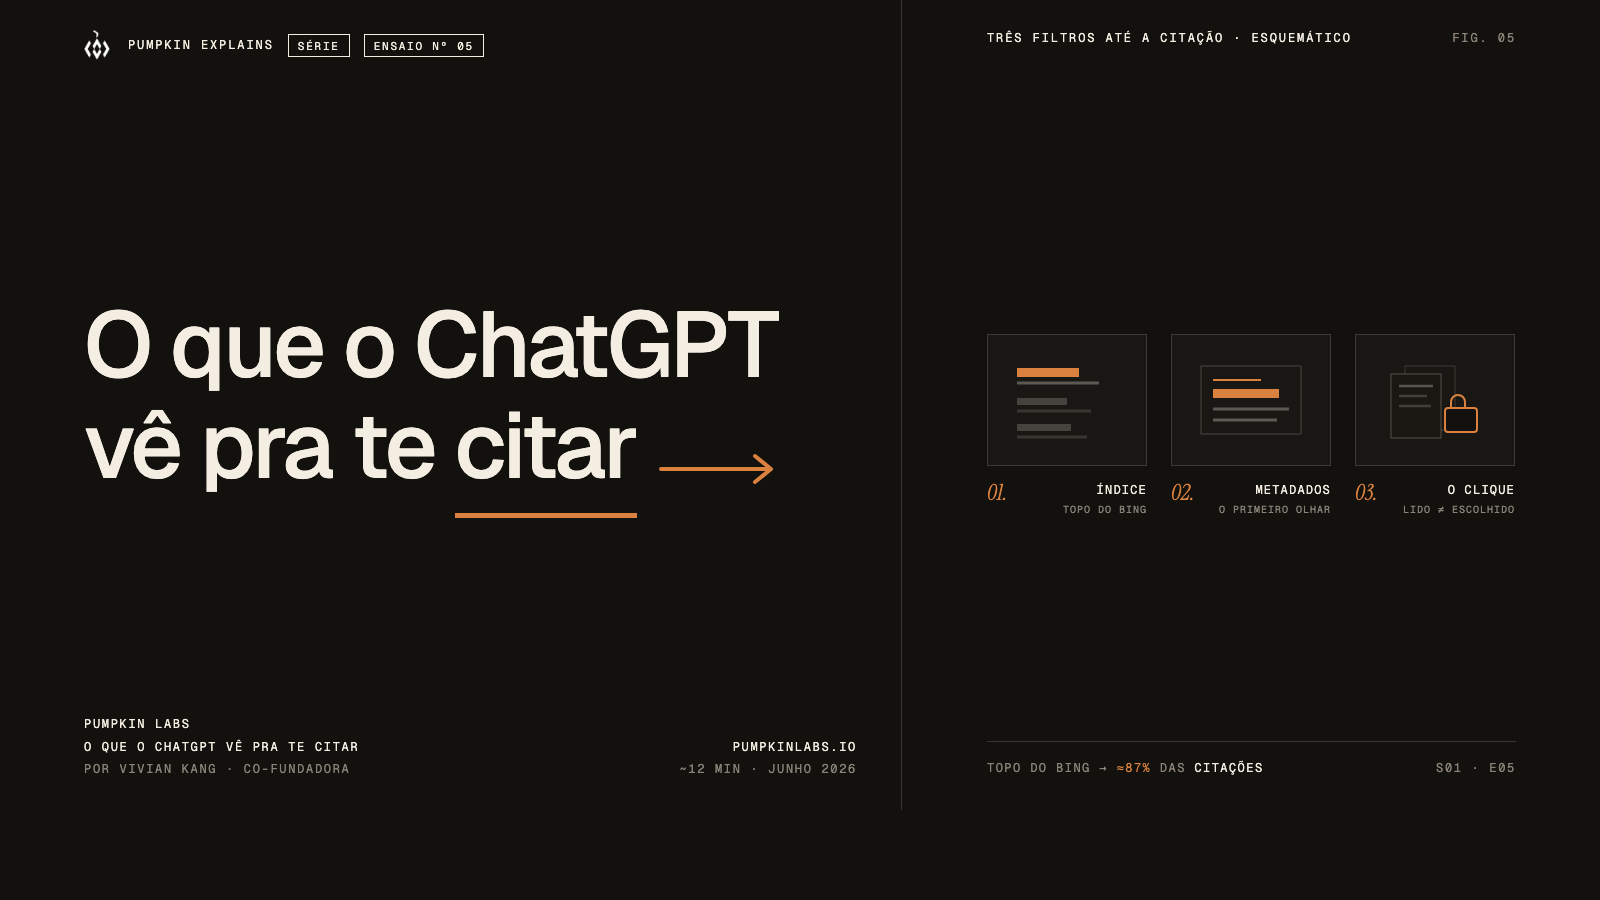
Como o ChatGPT escolhe quem citar quando busca na web: o pipeline de busca, por que na hora de escolher ele só vê título, descrição e URL, e o que de fato faz uma página ser lida e citada.

Ler artigo completo
Como os LLMs perdem contexto em documentos longos
Inteligência Artificial
Como os LLMs perdem contexto em documentos longos
05 Jun 202614 min

Por que dar um documento longo inteiro ao modelo não garante que ele use o documento inteiro: falha de chunk no RAG e degradação de atenção em contextos longos, e o que reduz a perda.

Ler artigo completo
O que é um Graph RAG?
Inteligência Artificial
O que é um Graph RAG?
05 Jun 202613 min

O que é Graph RAG, o que é um knowledge graph, e por que o Graph RAG supera o RAG vetorial em perguntas de múltiplos saltos, hierarquias e relações tipadas — e quando o RAG comum já basta.

Ler artigo completo
O que é Harness Engineering?
Inteligência Artificial
O que é Harness Engineering?
03 Jun 202612 min

O modelo deixou de ser o gargalo. Harness engineering é a disciplina que projeta o runtime em volta do modelo — e é o que separa um protótipo frágil de um sistema que aguenta produção.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 02
Por que os
LLMs alucinam
Pumpkin Labs
Por que os LLMs alucinam
Por Vivian Kang · Co-fundadora
pumpkinlabs.io
~14 min · junho 2026
O mecanismo · esquemático
Fig. 02
01.
A loss
sem "não sei"
02.
Distribuição
pico · platô
03.
Grounding
fato tipado
"pedido do João?" → "#4837291" · p = 0.001
S01 · E02
Inteligência Artificial
Por que os LLMs alucinam
03 Jun 202614 min

Por que ChatGPT, Claude e outros LLMs inventam respostas com a mesma confiança que acertam — e o que reduz alucinação na prática.

Ler artigo completo
Como o ChatGPT funciona: a matemática por trás de cada resposta
Inteligência Artificial
Como o ChatGPT funciona: a matemática por trás de cada resposta
15 May 202615 min

Entenda como o ChatGPT e outros LLMs geram respostas: tokenização, embeddings, atenção e amostragem explicados sem fórmulas.

Ler artigo completo
O que é o AEO?
AEO
O que é o AEO?
20 Jan 20264 min

O que é AEO e por que ele é o futuro da visibilidade online.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 01
O futuro do
SEO
Pumpkin Labs
Marketing e IA
Por Pumpkin Labs
pumpkinlabs.io
~5 min · janeiro 2026
Busca e visibilidade · esquemático
Fig. 01
01.
Busca
palavras-chave
LLM
02.
LLM
resposta direta
✓
03.
Visibilidade
ser citado pelo LLM
de rank #1 para ser citado pelo LLM
S01 · E01
SEO & AEO
O Futuro do SEO com LLMs
15 Jan 20265 min

Como os modelos de linguagem estão transformando a descoberta de conteúdo online.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 02
Graph RAG
na prática
Pumpkin Labs
Aplicações Práticas
Por Pumpkin Labs
pumpkinlabs.io
~8 min · janeiro 2026
Grafo + retrieval · esquemático
Fig. 02
01.
Nós
entidades ligadas
query
02.
Retrieval
busca no grafo
LLM
03.
Resposta
contexto estruturado
graph rag vs vector rag → contexto estruturado vence
S01 · E02
Graph RAG
Graph RAG na Prática
10 Jan 20268 min

Um guia completo para implementar sistemas RAG baseados em grafos de conhecimento.

Ler artigo completo
Pumpkin LabsPumpkin ExplainsSérieEnsaio Nº 03
Agentes em
produção
Pumpkin Labs
Engenharia de IA
Por Pumpkin Labs
pumpkinlabs.io
~10 min · janeiro 2026
Loop agente · esquemático
Fig. 03
LLMobsact
01.
Loop
observe, raciocine, aja
agentsearchcodeapiout
02.
Ferramentas
chamadas externas
orch.A1A2A3memória
03.
Escala
múltiplos agentes
n agentes · 1 orquestrador → sistemas autônomos em produção
S01 · E03
Agentes IA
Agentes Autônomos em Produção
5 Jan 202610 min

Lições aprendidas ao escalar sistemas de agentes inteligentes para milhões de usuários.

Ler artigo completo

Quer implementar essas soluções na sua empresa?

Entre em contato e descubra como podemos transformar seu negócio com IA.